我让 AI 画没有指针的钟,却得到指针和数字
我要求 AI 生成没有指针的钟,结果指针和数字都出现了。改写提示词时,我描述替代它们的表面,并检查提示词与模板中的视觉否定表达。
empty dial with no hands 给我生成了一个既有指针、又有数字的钟面。
提示词点名了我要去掉的东西,图片却把它们放了回来。
这不是只发生在钟表上的奇怪例外。提示词写下 No horns, no wings, no glow 时,同样的模式也出现了。这 3 个名词勾勒出了一个常见的奇幻生物形象,恰好就是我想避开的形象,结果反而像是在邀请模型把三者全画出来。
我的错误,是把图像模型当成了会按清单删除物体的工具。
它回应的是我提供的视觉概念。
模型画出了它熟悉的钟
没有指针的钟,描述的是一种缺失。模型仍然得把这种缺失变成像素。
我的措辞给了它钟、表盘和指针。no 原本是用来减去指针的,但这些可识别的名词提供了视觉结构。结果就成了这些词通常代表的普通钟表,指针和数字一应俱全。
解决办法不是加强否定,而是换一种描述:
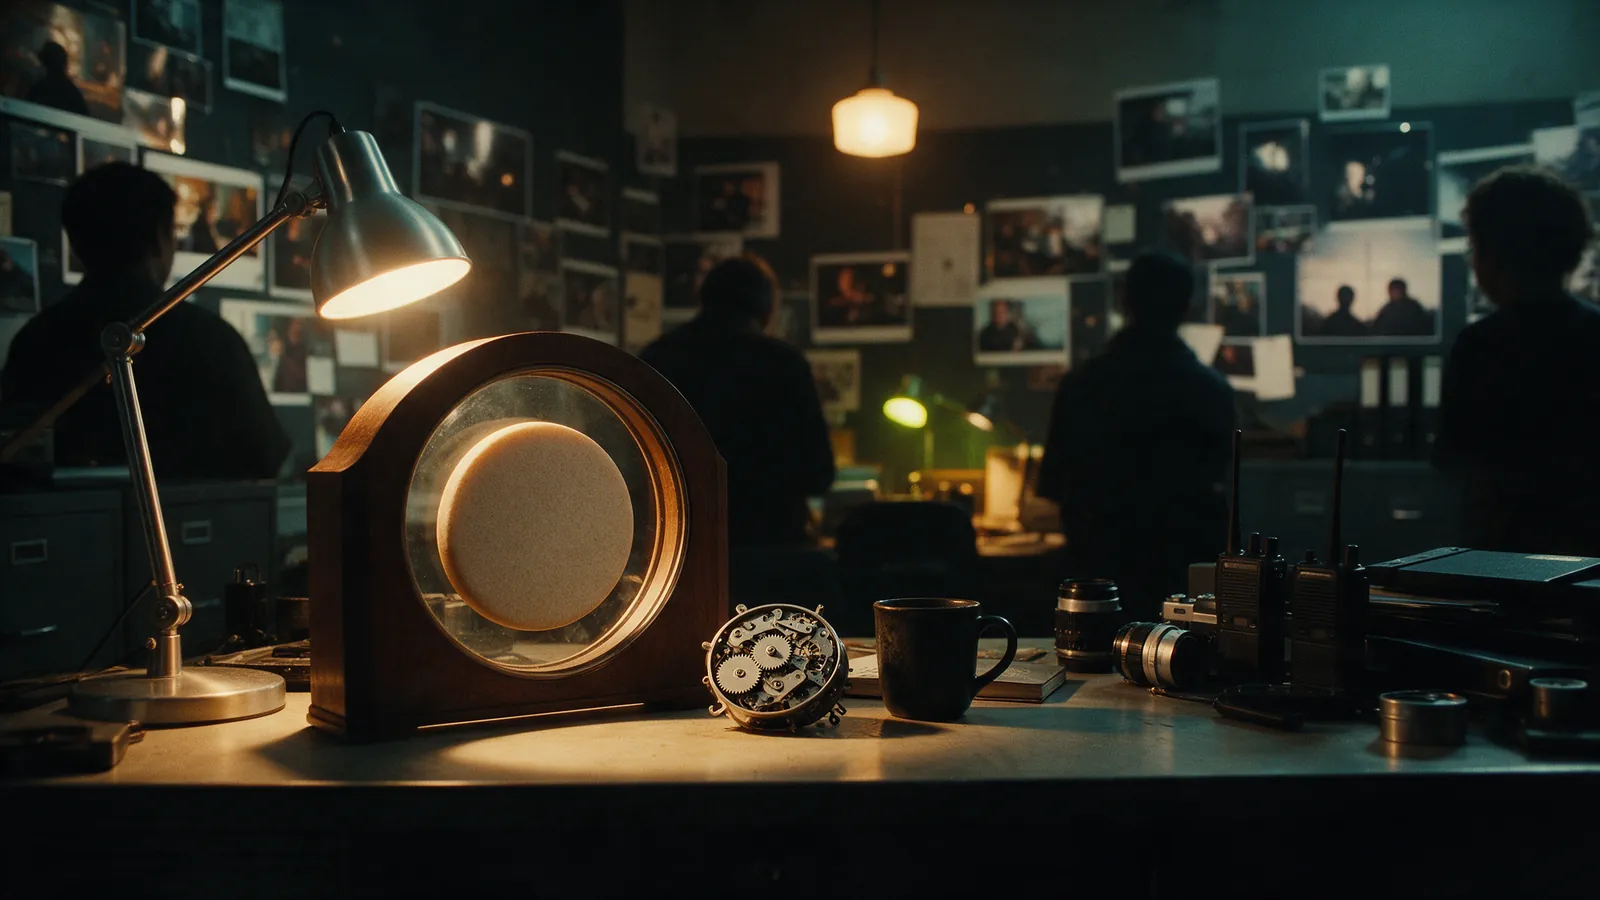
a smooth flat stone disc where the dial would be, an unbroken surface with no relief
这句提示词给了模型一个可以画出来的具体东西,放在通常属于钟面的位置。表面是平整的石头,连续完整,没有浮雕起伏。
想要的缺失,通过一个正向描述的视觉对象实现了。
这个区别改变了我写所有同类指令的方式。如果不想让某个可识别的东西出现在画面里,我就不再点它的名字,而是描述什么占据它的位置。
缺失也需要视觉设计
no horns 让模型想到角。
the skull is smooth and unbroken from brow to nape 描述的才是我真正想要的形态。
no wings 点名了翅膀。
the back is one continuous ridge of matted wool from shoulder to haunch 给背部指定了可见的形状和质地。
no glow 把发光带进了图像概念中。
the only light in frame is the overcast daylight already described, the hide absorbing it without sheen 则同时定义了光源,以及表面对光的反应。
同样的改法也适用于角色设计之外的场景。
我可以把 a room with no furniture 改成 bare floorboards running wall to wall, plain plaster walls。
把 no text on the sign 改成 a blank painted board, the paint even and unmarked。
与其依赖 empty, no people,不如通过剩下的形态描述一个无人的房间:the chairs pushed in, the only shapes in frame are the furniture already described。
每一次替换都不只是删掉一个名词,而是明确不要的元素消失以后,画面里应该有什么。
有些否定指令仍然应该保留
我没有删掉所有否定指令。
有一类范围明确的情况,否定仍然有用:生成瑕疵和不想要的渲染行为。
no floating props、no fused digits、no extra limbs、no duplicated frames 和 no morphing,描述的是图像生成方式中的错误。NOT slow motion 告诉视频系统运动应该如何呈现。gravity and inertia respected 则给结果设定了一条物理规则。
这些不是我要求模型从场景里擦掉的可见物体,而是渲染或运动的属性。
如果模型提供专门的负面提示词字段,这些指令就应该放在那里,而不是主提示词里。
由此,我有了一个简单的判断方法。
不想要的东西本身能被拍下来吗?有形状吗?会占据像素吗?如果会,我就用正向描述写出替代它的东西。
它是悬浮、融合、重复、形变,或不想要的慢动作这类生成缺陷吗?如果是,就可以保留为禁止项。
钟表指针属于第一类。它们是可见的物体,点名就会让它们的视觉概念继续活跃。光滑石盘之所以有效,是因为它用一个具体表面替换了这些物体。
我加了一项机械检查
正常阅读提示词时,很容易漏掉这种错误。without hands 这样的短语在人看来很精确,像是一条清楚的指令。
于是,我开始在生成之前搜索提示词中可能存在的视觉否定表达:
grep -nEi '\b(no|without)\s+[a-z]+'
每个匹配项都必须有保留的理由。如果描述的是允许使用的引擎行为约束,就可以留下。如果点名了可识别的视觉元素,我就改写成应该出现在那里的表面、形状、材质、光线或空间内容。
一次检查在 162 条提示词里找到了 3 处匹配,全部涉及同一个元素。同样的搜索还在模板中找到了另外 3 处,包括 no visible text。
后一个发现很重要。如果我只改当前的提示词,就会把这些措辞留在用于生成后续提示词的模板里。因此,模板和生成出来的文本都得查。
同一个错误,有几种表现
这条底层规律也能解释其他顽固的输出问题。
写明人物在看哪里,比说人物没有看镜头更容易得到正确的视线。
动作也一样。建立具体的身体位置和支撑关系,比依赖一个动作动词更有效。going up the stairs 仍可能生成一个站在楼梯平台上的人,因为预期动作还没有被落实到具体的身体状态。
缺失遵循的也是同一套逻辑。我不能指望一个被否定的名词,替我构建出替代画面。
提示词需要可见的依据。
对钟来说,是连续的石质表面。对头骨来说,是从眉部到后颈不中断的轮廓。对房间来说,是地板和素净的墙面。对标牌来说,是均匀、没有痕迹的漆面。
我现在的规则很简单:视觉上的缺失,要写成可见的替代物。否定留给渲染缺陷和引擎行为。
今天就搜索一下提示词里的 no 和 without。每当它们后面跟着一个可见物体的名词,就把禁止项改成具体描述,说明那些像素应该由什么占据。
这篇文章里的每个解决办法,都是先犯了错才换来的。错在我的电影里,总比错在你的品牌上好。